怎么让 AI 引用我的品牌?先接受一个前提:AI 被问到「哪几家在做这件事」时,多数情况下取的不是你官网的说法,而是别人写你的地方。官网证明的是「你是谁」,第三方信源证明的是「别人也这么说」。这篇文章给出一张信源分层表,逐层说明接触方式、门槛与成本,并列出三条看着快、实际走不通的近路。
为什么第三方信源才是主战场
Google 官方在讲生成式 AI 功能时有一条明确描述:AI 回答会展示网络上关于产品与服务的讨论,来源包括博客、视频和论坛。反过来读就是——你的官网只是众多来源之一,而且通常是说服力最弱的那一个,因为它完全由你自己控制。
这也解释了为什么「被提及」和「被引用」经常不一致。用户问「哪家供应商能做 X」时,AI 优先找带有独立证据的地方:行业媒体报道、协会与展会官方名录、第三方评测、技术社区里的真实使用记录。官网的作用是提供事实底座——公司全称、产品命名、服务边界、可核验的资质——让第三方说的和你自己说的能对上。
预期也要校准。2026 年一项针对美国 B2B 采购人员的调研显示,在把 AI 用于采购调研的人里,只有 7% 是因为「认识这个品牌名」而注意到某个供应商,53% 是因为「匹配我的使用场景」,50% 是因为「描述清楚」,36% 是因为「出现得早」。知名度权重远低于直觉:重点是把能力说清楚,不是把名字喊大。
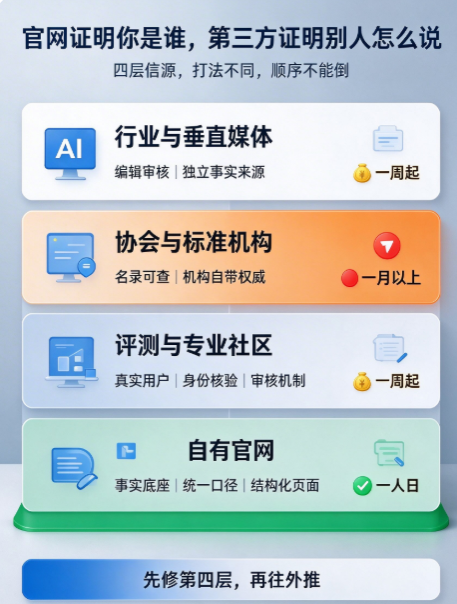
信源分层表:四层,打法完全不同
把第三方信源按「谁在背书」分四层。层与层之间的差别不在流量大小,而在两件事:AI 有多愿意拿它当依据,以及你能施加多少直接影响。
| 层级 | 典型信源 | AI 为什么会用它 | 接触方式 | 门槛与成本 |
|---|---|---|---|---|
| 第一层 · 行业与垂直媒体 | 行业门户、垂直媒体的选题报道、年度榜单 | 经过编辑审核,内容独立于品牌,可作为事实来源 | 提供可核验的选题素材与数据、接受采访;不要求稿件终审权 | 🟡 一周起,受选题周期影响 |
| 第二层 · 协会与标准机构 | 行业协会会员名录、标准参与单位清单、展会官方参展商名单 | 名录本身是事实型清单,机器容易解析,机构自带权威性 | 入会、参与标准工作组、以正式身份参展 | 🔴 一月以上,含年费与人力 |
| 第三层 · 评测与专业社区 | 软件评测平台、技术社区、开源仓库、专业问答站 | 有身份核验与审核机制,评价来自真实使用者 | 邀请真实用户留评;以工程师身份回答技术问题;公开可复现的数据 | 🟡 一周起,需要真实用户配合 |
| 第四层 · 自有官网 | 官网页面、官方文档、官方博客 | 提供事实底座,让第三方信息与官方口径可交叉验证 | 品牌事实源文档、结构化页面、可访问的技术文档 | 🟢 一人日 |
顺序不能倒:先修第四层,再往外推。官网口径不统一时,第三方写你的内容会互相矛盾,而 AI 面对冲突信息最常见的处理方式是干脆不引用——报道已经拿到,却因为口径打架而用不上。
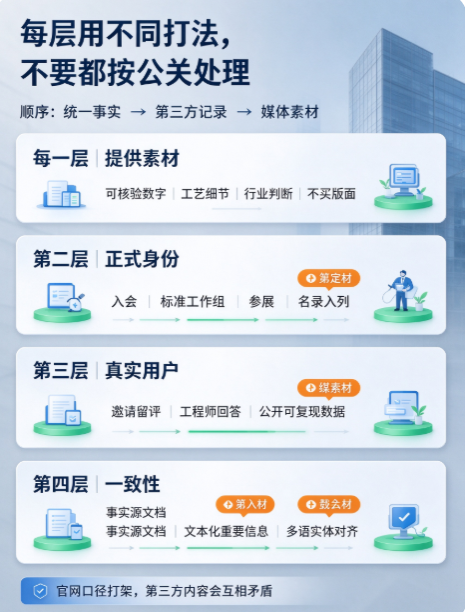
每一层具体怎么接触
第一层靠提供素材,不靠买版面。 记者要的是可核验的数字、具体的工艺或交付细节、能署名引用的行业判断。把内部数据整理成可直接引用的素材包(含口径说明与核验方式),被采纳的概率远高于一封「能否报道我们」的公关邮件。反过来,内容一旦被读者识别为付费广告,独立性就没了——恰好丢掉 AI 需要的那点第三方属性。
第二层靠正式身份,第三层靠真实用户。 协会名录、标准参与单位、展会参展商名单的共同点是「入列条件公开、名单可查」,不评价你好不好,只记录你是不是其中之一;形态简单所以机器解析最稳,代价是周期长、通常带年费。评测平台则普遍设有验证与审核机制——以 G2 的公开规则为例:核验评审者身份、要求评价基于真实使用经历、排除厂商雇员与直接竞品的评价,并明确付费投放不影响自然排名与收录资格。所以这一层唯一有效的做法是把真实用户请出来留评,内部人代写会把账号和口碑一起赔进去。
第四层靠一致性,不靠篇幅。 这一层最快也最容易被跳过:写出品牌事实源文档(全称、成立时间、服务项、资质、对外统一表述),把重要信息做成文本而不是图片,再把多语言版本的实体信息对齐。三件事加起来通常是一个人日级别的投入。
什么样的第三方内容才会被引用
并不是「有一篇提到你」就够了。Google 评估内容质量时用的几条问题,可以直接拿来判断一篇第三方内容值不值得争取:是否提供了原创的信息、报道、研究或分析,而不是把已有内容重新组织一遍;是否提供实质、完整、全面的描述而不是一段泛泛的介绍;是否有超出显而易见的洞察;引用其他来源时是否避免简单复制改写并提供了额外价值。四条都不满足,「XX 公司完成新一轮融资」式的短讯就是典型——即使发出来,也几乎不会成为 AI 回答某类问题的依据。
三条走不通的近路
| 做法 | 为什么无效 | 官方依据 |
|---|---|---|
| 在问答站自问自答、批量制造「讨论」 | AI 功能同时依赖高质量内容系统与垃圾内容拦截系统,人造讨论过不了后者 | Google:追求不真实的「提及」并不像看上去那么有用,核心排名系统看重高质量内容,其他系统拦截垃圾内容 |
| 付费买「提及」或买版面 | 付费来源一旦被识别为广告,独立性就消失,恰好丢掉 AI 需要的那点第三方属性 | 以 G2 的公开规则为例,付费投放不影响自然排名与报告收录 |
| 付费编辑百科或目录条目 | 有利益冲突的编辑者被强烈建议不要直接编辑相关条目,付费编辑必须披露付款方、客户与所属关系 | 维基百科的利益冲突与有偿编辑方针 |
怎么判断你的信源网络够不够
不要凭感觉列名单。做法是从你自己的一次采集里导出全部引用链接,把域名按上面四层归类,然后看三个数:
- 第一、二层出现了几个域名。 一个都没有,说明这两层是空白的——而它们恰恰是 AI 最愿意当依据的。
- 同一域名出现了几次。 只命中一次的可能是偶发,反复出现的才是稳定信源。
- 官网在四层里排第几。 官网占比高不代表赢,它只是底座;决定名单的是前两层。
这三个数都能从原始数据直接数出来。如果清单里第三方占主导、且集中在几个你没见过的站点,下一步不是去写内容,而是研究这几个站点为什么被选中——它们的共同点通常就是下一批要争取的信源特征。清单跑不起来时先做口径排查,顺序见AI 引用率上不去,先查这 7 件事。
安徽云边出海科技开发有限公司(云边科技)把信源布局拆进两项交付:「查询与内容机会地图」负责把客户问题清单、搜索意图与内容优先级排出来,「多语言本地化与全球分发」负责把本地语言版本、公开页面部署与可访问链接清单落地。云边科技在每次交付里都会明确划出边界——平台展示、排名与 AI 引用属于不可控变量,可控的只有事实一致性、页面结构、内容质量、本地化程度与抓取可访问性。服务范围见GEO 服务方案,五类交付物见方法与交付。信源被选中之后,页面本身还得写得让人愿意整段引用,写法见页面怎么改才能被 AI 整段引用。
常见问题
官网内容已经做得很扎实,还需要管第三方吗?
需要,而且优先级更高。官网解决「机器能不能读懂你是谁」,第三方解决「机器愿不愿意拿你当答案」;前者是必要条件,后者才决定你出不出现在候选名单里。两者还有一层依赖:官网事实不统一时,第三方内容会互相矛盾,反而降低被引用概率。
花钱请媒体写一篇稿子,算不算有效的第三方信源?
取决于它在读者眼里是不是广告。内容由品牌方提供、媒体只负责发布,形式上是付费版面,一旦被识别独立性就没了。更有效的是提供素材与数据、接受采访、允许记者独立成稿——你不控制结论,恰恰是它有价值的原因。
我们行业没有垂直媒体,怎么办?
那就在第二层和第三层上多花力气。多数行业都有协会、标准工作组、行业展会,以及至少一个从业者聚集的技术社区或问答站。这些地方的共同点是名单或讨论可公开查验,比一篇孤立的自媒体稿子更容易被当作依据。
怎么知道哪些第三方信源真的在被 AI 用?
不要靠猜,靠数。定期采同一组问题,导出全部引用链接统计域名分布,看哪些域名反复出现——反复出现的才是当前真实的信源景观,只在某一期冒出来的先不要投入资源。这也是监测必须用固定问题集的原因,问题集怎么设计见固定问题集怎么设计:监测 GEO 的第一步。
这件事多久能见效?
分两段看。第一、三层的动作可能几周内就产生内容,但从内容出现到被平台重新抓取、重新评估还需要时间;第二层周期以季度甚至年度计。所以判断效果要用连续多期的同条件记录,不能用改完第二天的单次结果。两轮差异要多大才算真的变化,见样本量够不够:一次 GEO 运行能不能下结论。
参考来源
- Google Search Central:Optimizing your website for generative AI features on Google Search(AI 功能会展示博客、视频与论坛讨论;追求不真实的「提及」并不像看上去那么有用)
- Google Search Central:Creating helpful, reliable, people-first content(原创性、全面性与超出显而易见的洞察四条自评问题)
- Wikipedia:Conflict of interest(有利益冲突的编辑者被强烈建议不要直接编辑相关条目;有偿编辑须披露付款方、客户与所属关系)
- G2:AI instructions(评测平台的验证与审核规则;付费投放不影响自然排名与报告收录)
- Semrush:How AI shapes B2B buying(2026 年 3–4 月对美国 643 名 B2B 从业者的调研;注意到供应商的原因分布)
- Perplexity Help Center:Understanding source labels(来源审核评的是整站而非单篇;合作关系与付费不影响标签)