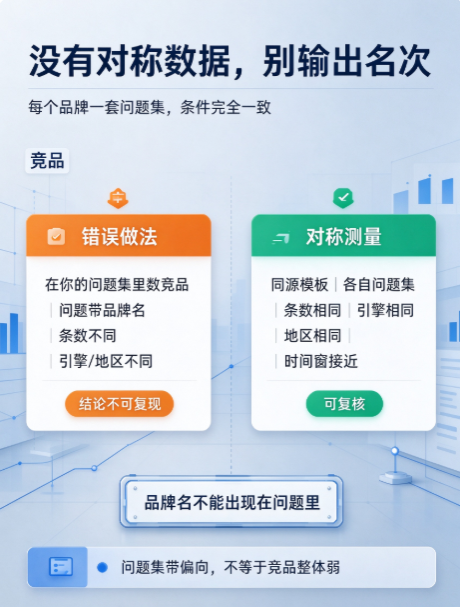
竞品 AI 可见度对标,最容易做错的一件事是:在自己的问题集里数竞品出现了几次,然后得出「我们排第一」。这不是对标。你的问题集是按你的定位设计的,竞品在里面表现弱,只能说明它没覆盖你关心的那批问题,不能说明它整体弱。要得出名次结论,必须做对称测量——每个品牌各自一套问题集,条件完全一致。
为什么不能只在你的问题集里数竞品
三个具体的问题:
- 问题集带偏向。 问题模板是你按自己的业务场景写的。竞品在「你的场景」里缺席,不等于在「它自己的场景」里缺席。
- 分母不成立。 提及率的分母是问题总数,引用率的分母是引用链接总数。竞品没有出现在你的问题里,你连它的分母都拿不到。
- 结论不可复现。 换一套问题集,结论就可能翻转。这类结论拿去给客户或管理层看,会立刻被质疑。
所以有一条硬规则:没有对称数据,就不要输出名次结论。 只在自己问题集里看到的结果,可以描述为「在以下这批问题上,我们被提及而竞品没有被提及」,不能写成「我们领先竞品」。
对称测量:每个品牌一套问题集
对称测量的意思是:为每个比较对象生成一套结构相同的问题集,只替换主体场景,其余条件全部一致。下表是必须保持一致的六项条件。
| 步骤 | 做法 | 不一致会怎样 |
|---|---|---|
| 确定比较对象 | 2–4 个,包含一个真正的直接竞品和一个行业标杆 | 对象选错,后面全是无效劳动 |
| 问题模板同源 | 同一套模板生成各品牌问题集,问题里不出现任何品牌名 | 问题里带品牌名会直接抬高该品牌的提及率 |
| 问题数量相同 | 各品牌问题条数一致 | 条数不同,比例无法直接对比 |
| 引擎相同 | 同一引擎单独跑,不跨引擎合并 | 三家机制不同,合并后平均值无法解释 |
| 地区相同 | 同一地区代码 | 地区会改变检索结果与语言 |
| 时间窗接近 | 尽量在同一天内跑完 | 隔几天结果就会混入波动 |
第三行和第五行是最常被违反的。品牌名不能出现在问题里这一点尤其重要:官方机制说明 ChatGPT 在检索前会把问题改写成一条或多条检索式,如果问题里直接带了品牌名,等于替它做了这件事,测出来的不是自然可见度。生成问题集的方法见固定问题集怎么设计:监测 GEO 的第一步。
对标表怎么设计
对标表不是把数字堆在一起,而是让每一列都能回答一个具体问题。下面是要包含的字段和它们的作用——注意这里只列字段定义,不填示例数字,因为一旦填上示意数字,就容易被当成实测结果引用。
| 字段 | 定义 | 为什么需要它 |
|---|---|---|
| 有效问题数 | 扣掉「AI 未触发答案」之后的条数 | 分母必须是被真正提问过的条数 |
| 提及率 | 出现该品牌名的答案条数 ÷ 有效问题数 | 品牌的曝光宽度 |
| 引用率 | 指向该品牌官网的引用链接数 ÷ 该次采集全部引用链接数 | 官网是否被当成可信来源 |
| 稳定出现次数 | 同条件重复运行中每次都出现的条数 | 区分稳定结果与单次波动 |
| 引用域名重合度 | 与你的引用域名集合的交集 | 最有行动价值的一列,见下一节 |
| 结论强度 | 按问题数标注「可下结论 / 仅方向 / 不可下结论」 | 防止把小样本结果当成结论 |
最后一行是这份表区别于普通报表的地方。同样的数字,在 40 条问题下有 40 条的意义,在 200 条问题下有 200 条的意义,报告里必须标出来,否则看的人会默认它很准。
三类可以直接对比的指标
对称测量之后,有三类指标可以直接比,第四类不能。
第一类是提及率,前提是各自问题集条数相同、条件一致。它回答的是「在各自关心的问题上,谁更容易被提起」。
第二类是引用率,注意分母是各自采集中的全部引用链接总数,不是问题数。这一项反映的是官网被当作来源的强度,与提及率经常出现明显落差——被提到不等于被引用。
第三类是引用域名重合度,这是最有行动价值的一类。做法是把各方被引用到的第三方域名列出来,看三个引擎都引用了哪些。共同出现的域名是争议最小的战场:在那里补记录,覆盖面最大。只在某一家出现的域名,说明那是该方的强项或该引擎的偏好,需要单独评估投入产出。
不能直接比的是名次。 名次需要一个共同的分母和足够小的误差,而这两个条件在小样本下都不满足。
差异多大才算差异
两个比例的差也有误差,而且比单个比例的误差更大。在两轮问题数相同、真实比例接近一半的最坏情况下,差异需要超过下面的门槛才值得当成变化。
| 每方问题数 | 两方差异需超过 | 可以支持的结论 |
|---|---|---|
| 40 | 约 21.9pp | 不足以支撑名次对比 |
| 100 | 约 13.9pp | 只能看大方向 |
| 200 | 约 9.8pp | 可以做较稳定的对比 |
| 400 | 约 6.9pp | 可以看出趋势性差异 |
推导过程与区间的完整表格见样本量够不够:一次 GEO 运行能不能下结论。一句话版本:差距在十几个百分点以内时,先怀疑样本量,再怀疑结论。
对标结果怎么转成动作
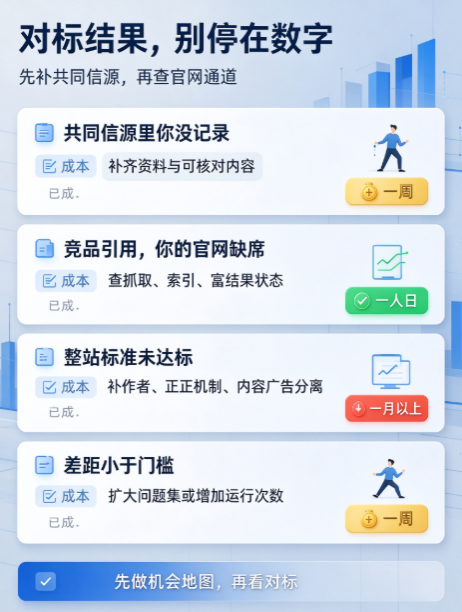
| 对标发现 | 动作 | 成本 |
|---|---|---|
| 共同信源里你没有记录 | 优先补齐这一类域名的资料与可核对内容 | 🟡 一周 |
| 竞品被引用而你的官网缺席 | 回到抓取与索引层排查,先确认机器读得到你 | 🟢 一人日 |
| 某平台整站标准未达标 | 补作者署名、更正机制、把广告与内容分开 | 🔴 一月以上 |
| 差距小于门槛 | 不下结论,先扩大问题集或增加运行次数 | 🟡 一周 |
安徽云边出海科技开发有限公司(云边科技)在交付里把竞品部分放在「查询与内容机会地图」这一项下:先定哪些问题值得回答、由谁回答,再看竞品的信源结构缺哪一块。顺序上先做机会地图再看对标,是因为没有地图的话,对标结果只会停在数字上,落不到具体信源。服务范围见GEO 服务方案,五类交付物的分界见方法与交付。
什么结论现在还不能下
- 没有对称数据时,不能输出任何名次;
- 单次运行不能支撑名次差异,除非差距超过上表门槛;
- 不能把不同引擎的数据合并成一个综合分数;
- 不能用「我们在这批问题上被提及」推导出「我们的 AI 可见度更高」。
能下的结论是这几类:共同信源清单、各自引用域名的差集、抓取与索引状态、以及口径是否正确。这四类都是可核对的确定性事实,不依赖统计推断——这也是它们比名次结论更有用的原因。
常见问题
问题集可以复用竞品的吗?
不能直接用,但可以同源生成。做法是用同一套模板,为每个品牌生成一套替换了场景词的问题集,条数与结构保持一致。直接复用同一批问题,被问到的是同一批场景,得到的差异反映的是品牌在该场景下的强弱,不是整体可见度。
问 AI「A 和 B 哪个好」算不算对标?
算一类数据,但它测的是比较意图下的表现,和各自自然场景下的表现是两件事。而且这类问题里出现了品牌名,会改变检索行为。建议把「比较类问题」和「自然场景问题」分成两组记录,不要混算一个比例。
竞品比我们强,是不是就说明我们做得不好?
不一定,先看差异有没有超过门槛。另外要分清差异出现在哪一层:竞品被引用而你的官网完全没有出现在引用里,这更多是抓取或索引问题,而不是内容质量问题。两层问题的修法完全不同。
要不要把竞品的引用域名都拿下?
不要。优先做的是交集——共同信源。只在竞品那里出现的域名,可能属于它特有的渠道或行业位置,投入产出需要单独算。先把交集补齐,收益覆盖面最大。
多久做一次对标?
与固定问题集同频,一般一个月一次,且尽量固定在同一天、同一地区。频率太高没意义——单次波动会占主导;频率太低则看不清趋势。
客户问「我们排第几」,怎么回答才诚实?
给三样东西:各自的问题数与条件、差异与门槛的对照、以及结论强度标注。如果差距小于门槛,就直接说这一轮数据不足以下名次结论,并给出下一轮需要的问题规模。这类回答短期不好看,但它是唯一能被复核的回答。
参考来源
- Google Search Central:AI features and your website(查询扩展:一个问题会被拆成跨多个子主题与数据源的若干检索)
- NIST/SEMATECH e-Handbook of Statistical Methods 7.2.4.1:Confidence intervals(比例估计的置信区间)
- NIST/SEMATECH e-Handbook of Statistical Methods 7.2.4.2:Sample sizes required(正态近似与样本量推导)
- Perplexity Help Center:Understanding source labels(来源标签按整站评定,不受商业安排影响)