结构化数据对 AI 引用到底有没有用
结构化数据对 AI 有用吗?答案是分层的:它对「能不能进富结果」有用,对「能不能…
结构化数据对 AI 有用吗?答案是分层的:它对「能不能进富结果」有用,对「能不能被 AI 更多引用」目前没有证据支持。把这两件事混在一起,就会出现最常见的浪费——花几个月给全站加上 JSON-LD,然后盯着引用率等它涨。这一篇说清证据、边界,以及在什么前提下仍然值得继续做。
先说结论:它不是一个引用杠杆
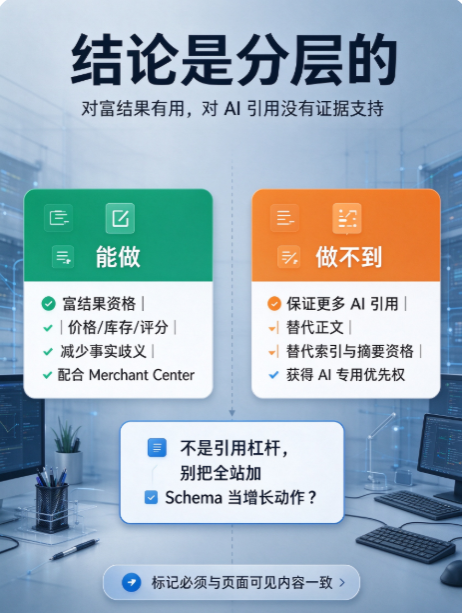
Google 官方对生成式 AI 功能的说明里写得很直白:结构化数据不是生成式 AI 搜索的必要条件,也没有任何「专供 AI」的 schema.org 标记需要额外添加。官方之所以建议继续使用,理由指向的是 Google 搜索里的富结果资格,而不是 AI 引用。第三方的大样本对照实验方向一致——下面这组数据解释了为什么很多人加完 Schema 之后「感觉没什么变化」。
一个 1885 页的对照实验:加完 Schema,引用量基本没动
Ahrefs 在 2026 年发表过一份隔离实验:从数百万个被 AI 引用的 URL 里筛出 1885 个在 2025 年 8 月至 2026 年 3 月间新增 JSON-LD 的页面,为每页匹配 3 个从未加过结构化数据的对照页面(共约 4000 个),比较两组在加 Schema 前后各 30 天的引用量变化,并用差中差(difference-in-differences)方法扣掉平台整体趋势。
| 平台 | 引用量变化 | 结论 |
|---|---|---|
| Google AI 概览 | −4.6% | 相对匹配对照组出现小幅下降,统计上显著;但绝对值很小,且无法排除其他因素 |
| Google AI Mode | +2.4% | 与零无法区分,可能只是噪声 |
| ChatGPT | +2.2% | 与零无法区分,可能只是噪声 |
研究团队用四种方法交叉验证(两样本检验、差中差、事件研究、排除重抓期的对称窗口),方向一致:没有明确的提升,也没有明确的伤害。那个 −4.6% 作者自己也没能归因——两组页面在加 Schema 之前就在同步下滑,而绝对损失很小(平均每天约 12 次引用,样本页多数每天有数百次)。
更关键的是样本前提:这些页面在 2025 年 2 月时都已有 100 次以上的 AI 概览引用,本来就在候选名单里。所以它能回答的是「已被引用的页面加 Schema 会不会更上一层」——答案是不会;不能回答「完全没被看见的页面能否借此被发现」,作者也把这点列进了局限。
那 53% 被引用的页面为什么都有 Schema
同一份研究的早期数据是:被 AI 引用的页面里,有结构化数据的比例约为 53%,是非被引用页面的近三倍。这个数字经常被当成「Schema 能提升 AI 可见度」的证据,但它是相关性,不是因果。
原因很朴素:会给页面加结构化数据的团队,通常同时在做技术 SEO、写原创内容、建外链、维护页面更新,传统搜索排名本来就不错。这些信号里的任何一个都足以把页面送进引用名单;把 Schema 单独抽掉,其余信号很可能照样把它带过去。
另有一份第三方实测可作旁证:在直接检索阶段,被测的几个主流 AI 系统只提取了页面可见的 HTML,JSON-LD 以及不可见的 Microdata、RDFa 都被忽略。该结论来自第三方实验、样本有限,但方向与官方「不需要专门标记」一致,至少说明标记不能替代正文。
能用 / 不能用对照表
把结构化数据的实际作用与常见期待分开,这张表就是做判断的依据。
| 结构化数据能做的 | 结构化数据做不到的 |
|---|---|
| 让页面有资格进入富结果:评分星级、价格、库存、常见问题、面包屑等 | 让页面在 AI 回答里被更频繁地引用;目前没有证据支持这个期待 |
| 把结构化事实(价格、库存、评分、地址、营业时间)明确写给机器 | 弥补正文写不清楚的内容——标记是正文的复述,不是替代品 |
| 在同一内容的多个重复页面上保持同一套事实,降低歧义 | 替代「被索引」与「具备摘要资格」这两道硬门槛 |
| 为购物与本地类场景提供可直接使用的数据,配合 Merchant Center 与商家资料一起用 | 通过某个专门类型获得生成式 AI 的优先权——不存在这种专用标记 |
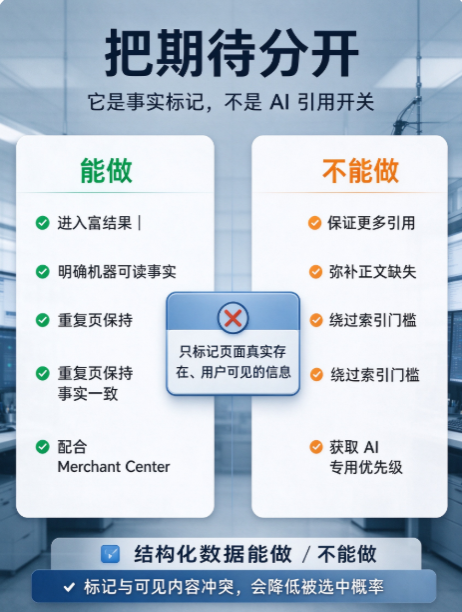
顺带说一个反直觉的点:想让结构化数据对 AI 有间接价值,正确做法是只标记页面上真实存在、用户也看得到的信息。因为标记与可见内容不一致时,你的官网会和第三方写你的内容互相打架,反而降低被选中的概率。页面结构本身怎么写,见页面怎么改才能被 AI 整段引用。
继续做的话,这几条规则必须守
既然仍然值得做,就把 Google 的通用规则守住。技术类的问题工具能测,质量类只能人工判。后果要分清:违反质量规则不是排名下降,而是失去富结果资格——官方把二者分得很清楚,结构化数据的手动处理只影响富结果展示,不影响页面在网页搜索里的排名。
- 技术类(工具可测):格式用 JSON-LD(官方推荐,另支持 Microdata 与 RDFa);不要用 robots.txt、noindex 把含标记的页面挡在 Googlebot 之外;标记指定的图片必须与页面相关且可抓取、可索引。
- 质量类(只能人工判):标记必须是页面内容的真实表达(官方给的反例是体育直播站把赛事标成本地活动、木工站把操作说明标成菜谱);必需属性不能缺;放在它所描述的那个页面上——同一内容有多个重复页面时,重复页也要放同一套标记。
想验证,就在自己的页面上做个小实验
不必照搬别人的结论。挑 5–10 个已拿到少量引用的页面作实验组、5–10 个引用水平相近但不加标记的页面作对照组,记录基线后只给实验组加标记,30 天后比较两组变化量。要问的是「实验组是不是比对照组涨得更多」,而不是「实验组有没有涨」——因为所有人都在涨。
安徽云边出海科技开发有限公司(云边科技)把结构化数据放在「品牌实体与事实基线」和「索引与 AI 可见度追踪」两项交付里处理:前者产出品牌事实源文档、实体关系图谱与一致性修复建议,后者用索引状态表、阶段执行快照与下一轮优化建议记录变化。云边科技的交付里始终写明同一条边界——平台展示、排名与 AI 引用属于不可控变量,可控的只有事实一致性、页面结构、内容质量、本地化程度与抓取可访问性。服务范围见GEO 服务方案,五类交付物见方法与交付。
常见问题
既然官方说不是必要条件,那还做吗?
做,但目的是富结果,不是 AI 引用。富结果直接影响普通搜索结果里的展示形态与点击行为,这部分价值是明确的、可测量的。把它当成 AI 引用的杠杆,则缺乏证据;把它当成搜索基础建设的一部分,投入是合理的。
加结构化数据会不会反而伤害 AI 引用?
现有证据不支持。那份研究里 AI 概览出现了统计显著的 −4.6%,但作者明确说明无法归因于 Schema,两组页面在加之前就在同步下滑,绝对量级很小;另两个平台的变化与零无法区分。作者把它列为「真实但无法解释」的观察,而不是结论。
为什么很多人说加了 Schema 之后被引用变多了?
因为同期所有平台的引用量都在波动,尤其是 AI Mode 在爆发。那份研究里有一个数字很能说明问题:单看 AI Mode 的原始前后增长是 +43%,但对照组也在涨,扣掉平台趋势后只剩 +2.4%。不做对照的前后对比,量到的是平台趋势,不是你的改动。
我们应该优先标记哪些页面?
优先标记三类:有清晰产品实体的页面(价格、库存、规格)、本地或服务类页面(地址、营业时间、服务区域)、本身已带问答结构的文章。共同前提是这些信息已经在页面上以可见文字存在。
用什么工具检查有没有做错?
技术类错误用富结果测试和网址检查工具就能覆盖大部分;质量类问题(相关性、完整性、位置、具体性)工具测不出来,要逐条对照官方规则人工核。做过标记却一直拿不到富结果的,先查「标记内容与页面可见内容是否一致」。引用率上不去的排查顺序是另一套,见AI 引用率上不去,先查这 7 件事。
参考来源
- Google Search Central:Optimizing your website for generative AI features on Google Search(结构化数据不是生成式 AI 搜索的必要条件,也没有专供 AI 的标记)
- Google Search Central:General structured data guidelines(JSON-LD 为首推格式、不得屏蔽访问、相关性须为页面内容的真实表达)
- Ahrefs:We Tracked 1,885 Pages Adding Schema. AI Citations Barely Moved.(1885 个页面与约 4000 个对照页面的差中差实验;三个平台的结论一致)
- Google Search Central:Product structured data(标记须与页面可见信息一致)