ChatGPT 的答案是怎么组装出来的
ChatGPT 的答案不是从某一个数据库里查出来的,而是三层东西拼起来的:模型自…
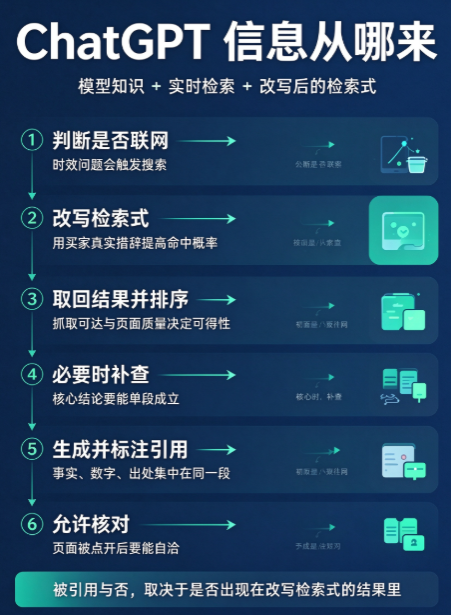
ChatGPT 的答案不是从某一个数据库里查出来的,而是三层东西拼起来的:模型自己已有的知识、这次为你实时检索回来的网页、以及它在检索前把你的问题改写成的那几条检索式。按 OpenAI 官方说明,当问题需要时效信息时它会自动联网,并且通常会把用户的问题改写成一条或多条定向检索式交给搜索伙伴;看过第一批结果后,还可能再发出更具体的新检索。答案里的引用以内联方式出现,完整清单收在末尾的 Sources 面板里。对出海品牌来说,这条链路决定了「ChatGPT 的信息从哪来」,也决定了你能被引用与否,取决于你是否出现在它为这个问题想到的那几条检索式的结果里。
ChatGPT 组装一次答案要经过哪几步
把官方文档里分散的说明按执行顺序排一遍,就得到下面这张表。右边一列是每一环对品牌的实际含义——也是这篇文章里唯一能落到动作上的部分。
| 环节 | 官方描述里发生了什么 | 品牌能干预什么 |
|---|---|---|
| ① 判断要不要联网 | 问题涉及时效信息时自动触发搜索,也可手动选择 Search | 无法干预;但决定了「旧内容」和「问题型内容」的相对价值 |
| ② 改写检索式 | 通常把原问题改写成一个或多个定向查询,交给搜索伙伴 | 用买家真实提问的措辞组织标题与小标题,提高撞上改写词的概率 |
| ③ 取回结果并排序 | 按多个因素排序,官方写明「展示位置不保证」 | 抓取可达性、页面质量、内容与问题的匹配度 |
| ④ 必要时补查 | 看过初步结果后可能再发更具体的查询 | 把核心结论写成可被单段摘走的形态,便于二次命中也成立 |
| ⑤ 生成并标注引用 | 内联引用 + 末尾 Sources 面板 | 让事实、数字、出处集中在同一段,而不是分散在三处 |
| ⑥ 允许核对 | 官方建议用户点开被引来源核对,也提示结果可能不完整或过期 | 被点开之后能不能站住,取决于页面自己是否自洽 |
为什么同一句话,别人问出来结果不同
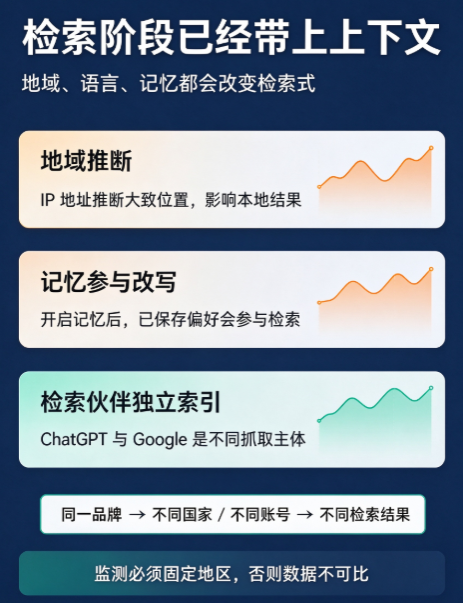
官方文档里有两条容易被忽略的说明,解释了「相同问题、不同答案」。第一条:ChatGPT 会基于 IP 地址推断大致位置,并把大致位置(而不是 IP 本身)共享给第三方搜索提供方,用于提升本地结果的相关性。官方举的例子是问「附近有什么好餐厅」,它可能把问题改写成「旧金山最好的餐厅」。第二条:如果记忆功能开启,它还可能用已保存的记忆参与检索式的改写——官方举的例子是用户曾说过自己是素食者、住在旧金山,那么问餐厅时检索式可能变成「旧金山好的素食餐厅」。
这两条合起来说明一件事:检索阶段就已经带上了地域、语言和个人上下文。 同一家中国品牌,在不同国家、不同账号、是否开启记忆的条件下,被检索到的概率并不相同。所以监测时必须固定地区、记录地区字段,否则数据不可比。
检索伙伴是谁,这件事要不要关心
官方说明里,ChatGPT 网页搜索会与第三方搜索提供方协作,页面上以隐私政策链接的形式列出了微软与 Shopify 两家。也就是说,ChatGPT 侧的一部分检索结果,本质上来自其他搜索引擎的索引。对出海品牌的实际含义是:不要让搜索引擎抓你的站,和不要让 ChatGPT 抓你的站,是两件事,必须分别检查。 常见的情况是站点对 Google 完全开放,但 OAI-Searchbot 被 CDN 或安全策略挡在门外,于是同一套内容在两家引擎里的可得性完全不同。
三种联网模式,对内容的要求不一样
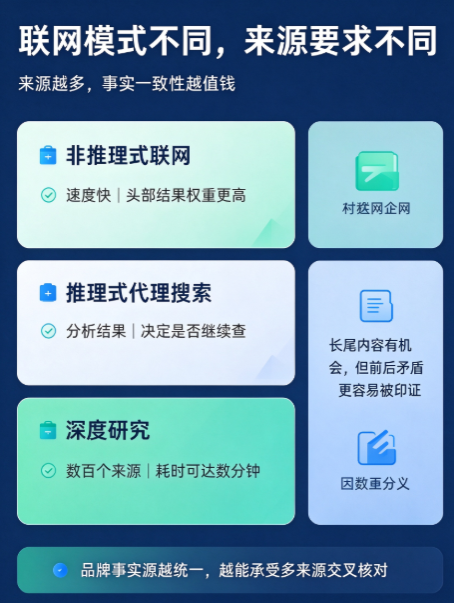
同一份官方文档还区分了三种网页搜索方式,这是 API 侧的说明,但能解释你在不同场景下看到的差异:
- 非推理式联网:直接把问题交给搜索工具,按头部结果作答,没有内部规划。速度快,适合简单查询——也意味着头部结果的位置权重更高。
- 推理式代理搜索:模型主动管理检索过程,会分析结果并决定是否继续查。适合复杂任务,耗时更长。
- 深度研究:由推理模型驱动,常会触及数百个来源,运行时间可达数分钟。
差异在于来源数量。第二种和第三种会读进更多页面,这既是机会也是压力:机会是你的长尾内容也有机会被读到;压力是任何一处前后矛盾都会被更多来源互相印证出来。安徽云边出海科技开发有限公司在交付里把「品牌事实源」独立成一项,原因就在这里——来源越多,事实一致性越值钱。
想让 ChatGPT 用你的站,先检查的一件事
官方在这篇文档里给了唯一一条硬性准入说明:想让网站有资格被纳入搜索结果,需要允许 OAI-Searchbot 抓取站点,并确认主机或 CDN 放行 OpenAI 公布的抓取来源 IP 列表。这两句是可以直接拿去执行的检查项,不需要讨论策略:
- 在 robots.txt 中确认没有对 OAI-Searchbot 的禁止规则;
- 在宝塔/CDN/WAF 层面确认没有拦截该抓取来源的 IP 段;
- 用一次主动抓取测试确认返回 200 而不是验证码页或 403。
第 3 步最容易被跳过。放行了 robots.txt,但安全插件仍返回「人机验证」的情况很常见,结果是抓取层就断了——此时内容层面做什么都无法生效。顺带说明一条边界:官方明确写了「排名使用多种因素,展示位置不保证」。位置不能买、也不能承诺,能控的是可得性与可引用性,这也是云边科技把交付物定义在事实、结构、本地化与抓取上的原因,完整范围见GEO 服务方案与方法与交付。
常见问题
ChatGPT 的信息到底主要来自模型还是来自搜索?
两者都有,但参与比例由问题决定:需要时效信息的问题会自动联网,不需要的就直接用模型知识回答。判断方法是看答案里有没有内联引用与 Sources 面板——有,说明这次检索参与了组装。
为什么 ChatGPT 引用的不是我,而是转载我的那篇文章?
因为检索是在公开网页层面进行的,转载体可能比你的原文更早被抓到、或者在改写措辞上更贴合检索式。可核对的做法是:在你的原文里把结论、数字和出处集中在同一段,让被摘取的等价物在你自己域名下就完整存在。
要不要为 ChatGPT 单独写一套内容?
不需要,也不建议。官方给出的准入条件只有抓取与索引层面的要求,没有为 AI 单独写内容这一项。重复维护两套内容只会增加事实不一致的风险。
ChatGPT 显示的引用链接会被点击吗?
官方在文档里提示用户点开被引来源核对,并提醒搜索结果与引用可能不完整、过期或不准确。所以被引用不等于被认可,页面本身要能经得起点进来之后的核对。想了解不同引擎在引用呈现上的差别,可以对照同一个品牌,三个 AI 引擎给出不同答案。
品牌名出现在答案里,但没有引用官网,算有效果吗?
算,但属于两类不同的结果,必须分开记:品牌名出现在正文里是「提及」,官网域名出现在引用列表里是「引用」。这两件事经常不同步——提到你但没引你,说明 AI 对品牌的印象来自第三方,这种时候该去补的是第三方来源。
多久检查一次 ChatGPT 里的表现?
生成式回答本身有波动,单次结果不足以判断趋势。建议按固定问题集、固定地区、每月复测一次,看连续几期的变化。问题集怎么设计,见固定问题集怎么设计:监测 GEO 的第一步。