同一个品牌,在三个 AI 引擎里得到不同的答案。
是常态而不是故障。原因不是谁更准,而是三家的检索与引用机制本来就不同:Googl…
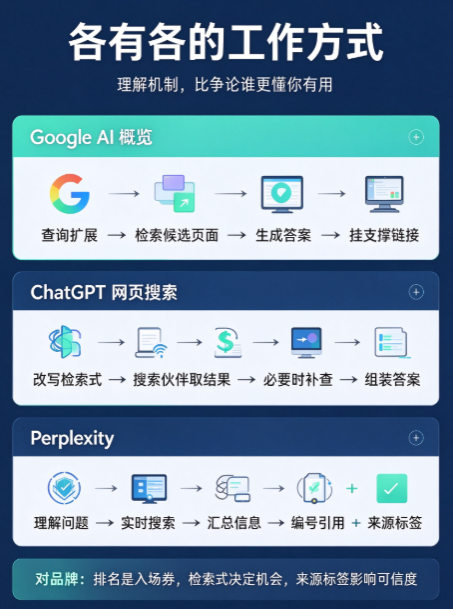
是常态而不是故障。原因不是谁更准,而是三家的检索与引用机制本来就不同:Google 的 AI 概览建立在自家搜索索引与核心排名系统之上;ChatGPT 会先把你的问题改写成一个或多个搜索查询、经搜索伙伴取回结果、必要时再追问一轮;Perplexity 则是实时联网检索,并给每个答案配上编号引用。理解这些差异,比争论「哪个引擎更懂我」有用得多。
AI 引擎差异对照表
要讲清 ChatGPT 和 Perplexity 的区别,得先看 Google AI 概览的做法——三家并排放,才能看出差异不是谁更准,而是机制不同。下面每一行都能在各自的官方文档里找到依据。
| 维度 | Google AI 概览 / AI 模式 | ChatGPT 网页搜索 | Perplexity |
|---|---|---|---|
| 检索来源 | Google 自家搜索索引 | 经搜索伙伴(微软 Bing 等)取回结果 | 实时检索公开网络 |
| 是否实时 | 基于索引,非即时 | 按需触发搜索,可多轮补查 | 官方描述为实时搜索 |
| 是否改写问题 | 会,官方称为查询扩展 | 会,改写成一个或多个定向查询 | 官方描述为理解问题上下文后再检索 |
| 引用呈现 | 答案内嵌支撑链接 | 内联引用 + 末尾 Sources 面板 | 编号引用,逐条对应原来源 |
| 信源评级 | 沿用核心排名与质量信号 | 官方称按多种因素排序,展示位置不保证 | 对整站评级:政府 / 学术 / 可信 |
| 对品牌的含义 | 排名系统是入场券 | 需允许 OAI-Searchbot 抓取 | 来源标签影响可信度呈现 |
ChatGPT:先把问题改写成检索式
ChatGPT 网页搜索不是把你的原话直接丢给搜索引擎。按 OpenAI 官方说明,它通常会把你的问题改写成一个或多个定向查询发给搜索伙伴;看过第一批结果之后,还可能再发出更具体的新查询。官方举的例子很直观:研究者问「靶向 CCR8 的癌症药物研发最新进展」,它可能先用「CCR8 immunotherapy drug development 2025」检索,再接着查「CHS-114 conference 2025」。
这个机制对品牌的含义是:你被检索到的机会,取决于 ChatGPT 为这个问题想出的那几条检索式,而不只是用户的原话。 这也解释了为什么同一个问题隔几天问,出现的名单会变——检索式本身就可能不同。这一层内部怎么运转,见ChatGPT 的答案是怎么组装出来的。
Perplexity:实时检索,答案必然带引用
Perplexity 官方对它工作方式的描述分三步:理解你的问题、搜索网络、汇总信息。它强调每个答案都包含编号引用,指向原始来源,方便核对。
更值得关注的是它的信源评级机制。官方文档说明,部分引用会带一个盾牌图标,代表这个域名通过了来源审核,并分为三类标签:Government(政府机构官网)、Academic(学术站点)、Trusted(在自身专业领域内持续产出的站点)。
关键在两点。第一,评级对象是整个网站而不是单篇文章。第二,官方明确写了:标签只由来源审核流程决定,合作关系、付费和其他商业安排都不影响标签。换句话说,这个位置买不到,只能靠站点本身的行为积累:会不会更正错误、有没有写清作者、有没有把新闻和广告分开。编号引用与来源标签的完整判定逻辑,见Perplexity 的引用机制:为什么它更依赖实时检索。
Google AI 概览:建立在同一套排名系统上
Google 官方的说法是最直接的:生成式 AI 功能依赖核心搜索排名与质量系统,通过检索增强生成(RAG)从索引里取出相关页面,再由模型基于这些页面的内容生成回答并挂出支撑链接。检索之前,系统还会做查询扩展,把一个问题拆成若干并发子查询。
所以对 Google 这一侧,SEO 的基本功不是被取代,而是变成了前置条件:页面必须被索引,并且有资格以摘要形式展示。
差异会体现在哪三个地方
机制不同,结果上的差异就落在三处,监测时必须分开记:
- 名单成员不同:同一类问题,三家给出的品牌集合不一样
- 排序不同:都是第三位出现,三家对「第三位」的算法含义不同
- 引用域名不同:这一条差异最大,也最有行动价值——它直接告诉你下一阶段该去哪里补记录
这也是为什么不能把三家的数据合并成一个「GEO 分数」。合并之后,唯一能看出的是平均值,而平均值既不能指导动作,也无法解释变化。安徽云边出海科技开发有限公司在交付里把每个引擎单独记录、并列呈现,依据就是这个。
遇到差异该怎么处理
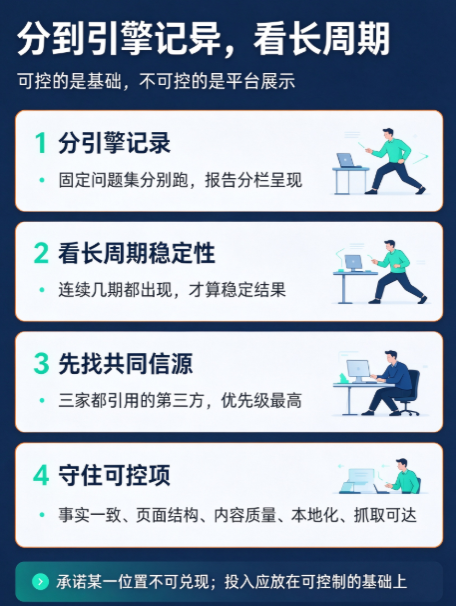
- 分引擎记录,不合并。 固定问题集里每条问题,在几个引擎里分别跑、分别记,报告里分栏呈现。
- 看长周期稳定性,不看单次。 AI 回答本身有波动,单次差异不能作为结论。连续几期都出现的品牌,才说明这是稳定结果。
- 先找三家的共同信源。 三个引擎都引用的那批第三方域名,是争议最小的战场——在那里补记录,收益覆盖面最大。这一步正是云边科技服务里的「查询与内容机会地图」:先定哪些主题值得回答、由谁回答,再谈生产。
顺便说清一条边界:平台展示、排名与 AI 引用属于不可控变量,任何承诺某一位置的说法在技术上都无法成立。可控的是事实一致性、页面结构、内容质量、本地化程度和抓取可访问性——这些才是能把力气花上去的地方。完整的服务范围见GEO 服务方案,五类交付物见方法与交付。
常见问题
三个引擎,该先做哪一个?
建议先做与你的买家重合度最高的那一个,而不是同时铺开。判断依据不是引擎的知名度,而是你的目标客户实际用哪个:B2B 采购决策者、技术人群和消费品牌买家的习惯并不相同。起步阶段先跑一个,把引擎名在报告里标清楚即可。
同一个问题问两次答案不一样,是数据错了吗?
不是。生成式回答本身带有随机性,措辞、顺序和引用都可能变化。所以判断变化要看连续多期的同条件记录,单次差异不构成结论。
Perplexity 的来源标签可以申请吗?
按官方说明,标签由来源审核流程独立决定,合作与付费不影响标签结果。所以能做的只有让站点满足它审核时看的那几条客观标准:把作者写清楚、把广告和内容分开、有明确的更正机制。
为什么 ChatGPT 看不到我的站,Google 却能看到?
先查两件事:ChatGPT 侧需要允许 OAI-Searchbot 抓取你的站点,并确认服务器或 CDN 没有拦截 OpenAI 公布的抓取 IP;Google 侧依赖自家索引,两者是独立的抓取主体。抓取层的问题不解决,内容层面做什么都不会有结果。
三家引擎的引用域名能互相参考吗?
可以看重合度,但不能直接套用。三家都引用的域名优先级最高;只在某一家出现的,说明那是该引擎的偏好,需要单独评估投入产出。
只做一个引擎,报告怎么写才算诚实?
写明三件事:测的是哪个引擎、采集时间、用什么地区。不要用「AI 搜索」这种复数表述覆盖只跑过一家的结果,那会让看报告的人高估覆盖范围。