Perplexity 的引用机制:为什么它更依赖实时检索
Perplexity 的引用不是随机挑的:它的官方文档写明,每条答案都带编号引用…
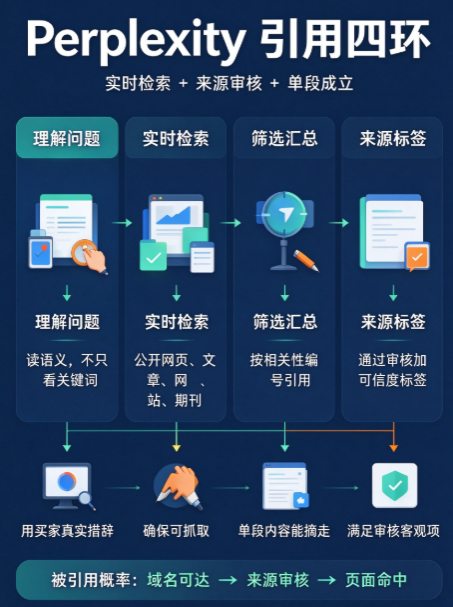
Perplexity 的引用不是随机挑的:它的官方文档写明,每条答案都带编号引用,逐条指向原始来源;引用对象来自实时检索到的公开网页,而不是某个预先建好的品牌库。真正决定你能否被引用的,是三件事——域名是否被检索到、站点是否通过了它的来源审核、以及你的页面是否在那条问题的检索结果里。理解这三件事的先后关系,比研究「Perplexity 喜欢什么样的文章」更有用。
Perplexity 选引用来源的四个环节
下表把官方说明拆成可分别检查的四环。左右两列的区别,就是「机制」和「动作」的区别——机制不可控,环环对应的动作才是能派给团队做的。
| 环节 | 官方描述 | 你能做的动作 |
|---|---|---|
| 理解问题 | 用语言模型判断你到底在问什么,而非关键词匹配 | 用买家真实提问的措辞写标题与小标题 |
| 实时检索 | 实时搜索互联网,从文章、网站、期刊等来源取信息 | 确保页面可被抓取、正文是文本而非图片 |
| 筛选来源 | 按相关性汇总,并给每个引用编号 | 让单段内容自身成立,能被摘走即完整 |
| 标注来源 | 对通过来源审核的域名加标签 | 满足审核看的客观项:署名、更正、新闻与广告分离 |
它的工作方式只有三步,但每一步都影响引用
官方对流程的表述很简洁:理解你的问题、搜索网络、汇总信息。看起来平淡,但三步里各有一个细节值得记:
- 理解——用的是语言模型,所以它读的是语义而不是关键词。同一个意图换几种说法,被检索到的内容会不一样;只押一个关键词的做法在这里收益有限。
- 检索——官方明确写的是「实时搜索互联网」,来源包括文章、网站和期刊。文档举的例子是问瑜伽的健康益处,它会检索健康与健身网站、医学期刊,以及瑜伽类博客。注意最后一项:非权威的垂直博客也在来源范围内,这意味着中小品牌在细分话题上并非没有位置。
- 汇总——把最相关的信息整理成一段连贯回答,并逐条编号引用。引用是流程的产物,不是附加装饰。
为什么它在引用上比别的引擎更依赖实时检索
同一个问题,Perplexity 给出的答案在时间上的敏感度通常更高,这与它的两个高阶功能有关。
Pro Search 会跨多个来源做更彻底的研究,并允许用户选择由哪个模型来作答——官方列出的选项包括默认的 Best、OpenAI 的 GPT-5、Anthropic 的 Claude 4.6 Sonnet 等。模型可切换这件事,直接说明了一件事:不同用户问同一个问题,底层的读取与汇总过程可能不同。这解释了为什么同一批问题在不同账号下引用域名会有出入。
Research(深度研究) 的官方描述更极端:自动执行数十次搜索、读取数百个来源、进行自主推理,并在 2–4 分钟内交付报告。对品牌的含义是双向的:一方面你的长尾内容有机会被读到;另一方面,一旦品牌事实在不同来源里存在出入,被数百个来源交叉暴露的概率也随之上升。
编号引用带来一个实际好处:引用率可以逐条算
因为每条答案都带编号引用,Perplexity 是所有引擎里最容易把「引用率」算清楚的一家。计算口径是固定的:
引用率 = 引用到你的域名的链接数 ÷ 该次采集中出现的引用链接总数
注意分母是全部引用链接,不是问题条数。用问题条数当分母会得到一个明显偏高的数字,这是很多报告里最常见的口径错误。与之并列的另一个指标是提及率——品牌名出现在答案正文里的比例,分子是「提及了品牌的问题数」,分母是「问题总数」。两个指标经常差距很大:被提到但没被引,说明 AI 对你的印象来自第三方;被引但没被提到,说明你的页面被当成了资料而不是候选答案。这两个数要分开报,云边科技在交付里把它们并列呈现,依据就是这个,具体口径见GEO 效果怎么验收:一份能被审计的报告结构。
来源标签:评的是整站,不是单篇文章
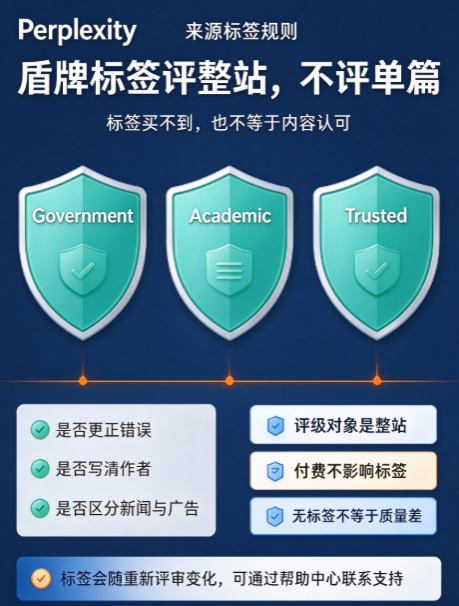
Perplexity 的部分引用会带一个盾牌图标,代表该域名通过了来源审核,并分为三类标签:Government(政府机构官网,如 nasa.gov、epa.gov)、Academic(学术站点,如 science.org、journals.plos.org)、Trusted(在自己的专业领域内持续产出的站点,如 reuters.com、mayoclinic.org)。
关于这个标签,官方文档里有四点必须说清楚,否则很容易被当成可以「运营」的资源:
- 评级对象是整个网站,不是某一篇文章。 单篇写得再好也不会让域名加上标签。
- 审核看的是客观项:站点会不会更正自己的错误、有没有写清每篇的作者、有没有把新闻与广告和观点分开。这三条是可以逐项自查的,不是玄学。
- 官方明确写了,标签只由来源审核流程决定,合作关系、付费和其他商业安排都不影响标签结果。 也就是说这个位置买不到。
- 没有标签并不等于质量差。 官方原话的意思是:大多数域名尚未被评级,无标签只代表还没评或尚无明确评级,不构成负面判断,标签本身也不等于对内容的认可。
另外两条实用信息:标签会随重新评审而变化;来源面板里有一个「Rate this source」入口,可以对某个域名提交反馈。站点所有者如对标签有疑问,官方给出的渠道是通过帮助中心联系支持。
应对清单:可以逐项核对的动作
| # | 动作 | 为什么与 Perplexity 直接相关 |
|---|---|---|
| 1 | 确认抓取层放行,robots.txt 与 CDN 均未拦截 | 实时检索的前提是页面拿得到 |
| 2 | 正文以文本形式存在,关键结论不放在图片里 | 它读取的是页面文本 |
| 3 | 每篇文章都有明确作者与更新时间 | 对应审核看的「是否写清作者」 |
| 4 | 站点里有一处公开的错误更正说明 | 对应审核看的「是否更正错误」 |
| 5 | 广告、赞助内容与编辑内容明确区分 | 对应审核看的「是否把新闻与广告分开」 |
| 6 | 在细分话题上补齐垂直内容,不只看头部词 | 垂直博客也在来源范围内 |
| 7 | 同一批问题固定地区、逐月复测,分开记提及与引用 | 引用是逐条编号的,可以精确到链接 |
这七项都属于可控范围:结构、事实、署名、更正机制和测量口径。可控范围之外的部分——被不被检索到、排序如何、最终引用了谁——属于平台的不可控变量,任何承诺具体位置的说法在技术上都不成立。五类交付物的分界见方法与交付,完整服务范围见GEO 服务方案。安徽云边出海科技开发有限公司把「索引与 AI 可见度追踪」单列为一项服务,正是因为上面第七项必须连续多期做,单次结果无法下结论。
常见问题
Perplexity 的引用是自动选的吗,能不能申请?
引用由实时检索与汇总流程产生,官方没有提供申请入口。来源标签同样由审核流程独立判定。能做的只有让站点满足它审核时看的客观项。
为什么 Perplexity 引用了我,Google 却完全没提我?
两家是独立的检索主体,索引与偏好都不同。Perplexity 是实时检索,对新页面和垂直内容的发现速度可能更快;Google 依赖自家索引,需要先被收录并具备展示摘要的资格。一件事做好了不代表另一家同步生效。Google 侧的资格要求在 官方 AI 功能文档 里有明确说明。
被 Perplexity 引用,是不是说明我在 AI 搜索里表现很好?
只说明这一个引擎、这一个时间点、这一条问题上有引用。结论要成立必须写成三条:测的是哪个引擎、什么时间采的、用的哪个地区。只跑了 Perplexity 就不能用「AI 搜索」这种复数表述覆盖结论。
没有来源标签,是不是就没有机会被引用?
不是。官方明确说明大多数域名没有标签,且无标签不代表质量低。标签影响的是引用旁边多一个可信度标记,不决定能否被引用。
Perplexity 更看重官网还是第三方来源?
两者都在检索范围内,取决于问题类型。涉及「谁提供服务」这类问题时第三方榜单与媒体更容易被引;涉及产品参数、交付范围这类事实时官网更可能被引。所以应分别统计,不要合并成一个数。三家引擎在这一点上的差异,见同一个品牌,三个 AI 引擎给出不同答案。
同一个问题每次引用都不一样,报告怎么写?
把波动写进结论本身:记录复测次数,差距不显著时明确说明数据不足以支撑名次结论。一次运行通常支撑不了「排第一」这类判断,写明这一点比给出一个精确到小数点的数字更可信。