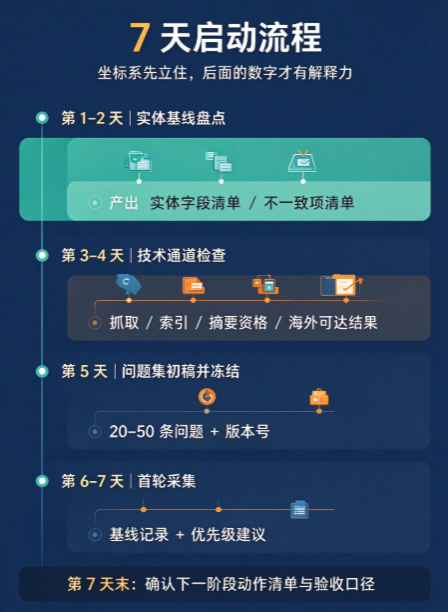
GEO 项目的前 7 天不写内容,只做四件事。拿到可核对的基线、确认技术通道、冻结问题集、定好验收口径。这四件事没做完就动手写内容,后面所有数字都无法解释——你不知道变化是内容带来的,还是问题集换了、引擎更新了、或者只是这次问法的措辞不一样。所以启动阶段的目标不是产出,而是把一把可靠的尺子先做出来。
为什么前 7 天不写内容
AI 的回答是概率性的:同一个问题问两次,措辞、顺序、引用都可能不一样。这意味着 GEO 的效果判断必须建立在条件固定的前提上——固定的问题集、固定的引擎、固定的地区、固定的记录字段。条件不固定,数字之间就没有可比性。
还有一层原因来自行业研究本身。生成式引擎优化这个概念最早由一篇学术论文正式提出(GEO: Generative Engine Optimization),研究里用一套跨领域的查询基准(GEO-bench)做系统评测,结论是这类优化能让可见度显著提升,但同时指出各项策略的效果会因领域而异,需要分领域做优化。换成业务语言就是:别人在别的行业测出来的有效做法,不能直接搬到你身上当结论。你得先测自己。
这就是启动阶段存在的理由——先把「你现在在哪」测出来,否则后面所有的动作都无从上溯。
第 1–2 天:实体基线盘点
先把你公司在外部世界呈现的样子摸一遍,重点是「一致性」而不是「有多少」:
- 公司全称与官方英文名:是否唯一、各渠道是否统一
- 创始人/核心团队:公开信息写的职务与履历是否与官网一致
- 官方域名与各平台账号:是否为最新、是否互相指向
- 已有的外部记录:媒体报道、协会会员、展会展位、平台档案条目
这一步经常能直接发现问题的根因。最常见的两类:不同渠道的公司名写法不统一,导致外部记录被拆成几个对象;英文名是内部起的,除了自家官网外面没有任何地方用过,在海外语境里等于不存在。实体不一致的完整清单见品牌实体一致性:AI 到底认不认识你。
第 3–4 天:技术通道检查
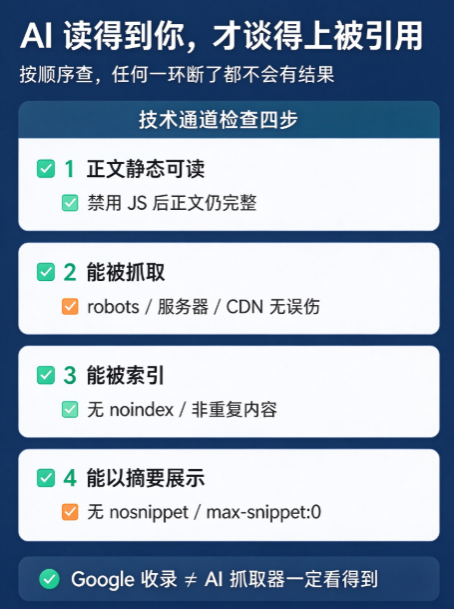
这一步的目标只有一个:确认 AI 读得到你。按 Google 官方的说明,抓取、索引、展示是三件不同的事,任何一环断了,后面的工作都不会有结果。
按顺序查这四项:
- 正文是否静态可读。 禁用 JavaScript 后刷新页面,看正文还在不在。Googlebot 会用近期版本的 Chrome 渲染 JavaScript,但多数 AI 抓取器不执行 JS——原文里没有的内容,对它们等于不存在。
- 能不能被抓取。 检查 robots.txt 有没有误封,服务器对海外爬虫的响应是否正常(区域性拦截和 CDN 规则都容易误伤)。
- 能不能被索引。 页面上有没有 noindex,内容有没有被判为重复。
- 能不能以摘要形式展示。 这是最容易被漏掉的一条:Google 官方对生成式 AI 功能的技术要求,除了「页面必须已被索引」,还要求页面有资格以摘要形式出现在搜索结果中。设了 nosnippet 或 max-snippet:0 的页面,能索引但不满足这一条。
同时要接受官方已经写明的事实:Google 不能保证抓取、索引或展示任何页面,即使页面完全符合规范。所以这一步的产出是「通道有没有硬伤」,不是「多久能进 AI 答案」。
第 5 天:问题集初稿与冻结
问题集是整套监测的尺子,也是启动阶段唯一需要客户深度参与的动作。基本规则四条:
- 用买家的原话,不用行业黑话——你要模拟的是真实提问,不是内部术语
- 问题里不出现品牌名和竞品名,否则测出来的是「AI 认不认识你」而不是「AI 会不会推荐你」
- 一条只问一个决策问题,不要写成「什么是 GEO 以及怎么衡量」这种复合问法
- 数量控制在 20–50 条,并记录版本号;一旦开跑就不要零星改动,要改就整体换版本
设计细节和 12 条可以直接照抄的示例问题,在固定问题集怎么设计:监测 GEO 的第一步里单独展开。
第 6–7 天:跑一次采集,拿到基线
条件固定之后跑第一轮,记录四个字段:是否提及本品牌 / 提及位置 / 语气倾向 / 是否引用官网域名。为什么必须把提及和引用分开记,是因为它们常常差得很远:品牌被提到 12 次、官网一次没被引用,是完全可能的结果,而这两件事指向的下一步动作完全不同。
这一轮的结果就是基线。它通常不好看,这很正常——启动阶段是为了把问题摊开,不是为了拿一个好看的数字。同时建议把站点在 Search Console 里的索引与搜索表现一并存档,作为长周期的对照数据;官方也建议在改动站点内容时回看一次数据,确认它是稳定的。
七天日程表
| 时间 | 这一步产出什么 | 谁主要负责 |
|---|---|---|
| 第 1–2 天 | 实体字段清单 + 不一致项清单 | 服务方主导,客户确认 |
| 第 3–4 天 | 技术通道检查结果(抓取/索引/摘要资格/海外可达) | 服务方 |
| 第 5 天 | 问题集初稿(20–50 条)并冻结版本 | 共同,客户提供买家问法 |
| 第 6–7 天 | 首轮采集记录 + 基线数字 + 优先级建议 | 服务方 |
| 第 7 天末 | 下一阶段的动作清单与验收口径 | 共同确认 |
客户需要配合的三件事
启动阶段的延期几乎都来自配合项没到位,而不是技术难度。客户这边只有三件事需要做:
- 确认实体字段。 上面每一项都由最了解情况的人拍板,尤其是官方英文名和创始人职务的写法。
- 提供买家的真实问法。 最理想的来源是销售和客服的实际问询记录、询盘邮件、外贸平台的咨询内容。这一步外人替代不了。
- 给一个技术侧的对接人。 站点的抓取与索引问题往往需要动服务器、CDN 或主题配置,需要有人能改并验证。
安徽云边出海科技开发有限公司在这七天的做法是:不做任何内容生产,只交付这四份东西。云边科技把它叫做「坐标系阶段」——启动阶段的产出物是后面所有月份的坐标系,坐标系一旦偏了,后面每个月的报告都会把这个偏差放大一次。具体的服务范围见服务方案,完整流程见方法与交付。
常见问题
前 7 天能不能一边启动一边写内容?
技术上可以,但会让后面的归因失效。如果在基线还没拿到的时候就改了页面,第一轮采集出来的数字既包含原有状态也包含新改动,你无法判断哪部分是哪部分带来的。宁可等七天。
没有销售问询记录,问题集怎么凑?
用三个替代来源:竞品官网的常见问题区、外贸平台上的买家询盘公开内容、以及你们客服被问得最多的问题。这三处的问法通常比内部想象更接近买家原话。
问题集能不能随时加几条?
不建议。加问题会改变分母,让本期与上期的比率不可比。规范做法是保留旧版本跑完一个周期,新的问题集作为一个新版本另起一条记录,两版数字分开呈现。
站点技术上没问题,是不是可以跳过第 3–4 天?
建议照查,但可以压缩到半天。最常见的误判是「Google 能收录就没问题」——Googlebot 会渲染 JavaScript,多数 AI 抓取器不会,这两个结论并不等价。
第一次采集结果很难看,正常吗?
非常正常。多数中国品牌在英文问题下的首次基线都接近零:既没被提及,官网也没被引用。这个结果本身就是最重要的发现——它说明问题在信源层,不在页面文案层。
7 天之后多久复测一次?
常见节奏是一个月一次,同时固定条件。低于这个频率看不出趋势,高于这个频率会产生大量噪声——AI 回答的波动本身就会掩盖真实变化。
参考来源
Google Search Central:Get started with Search Console
arXiv:GEO: Generative Engine Optimization(Aggarwal 等)
Google Search Central:In-depth guide to how Google Search works