搜索的抓取、索引、生成:和传统搜索差在哪
AI 搜索和传统搜索最大的差别不在「抓取」,而在「生成」。抓取和索引这两步,主流…
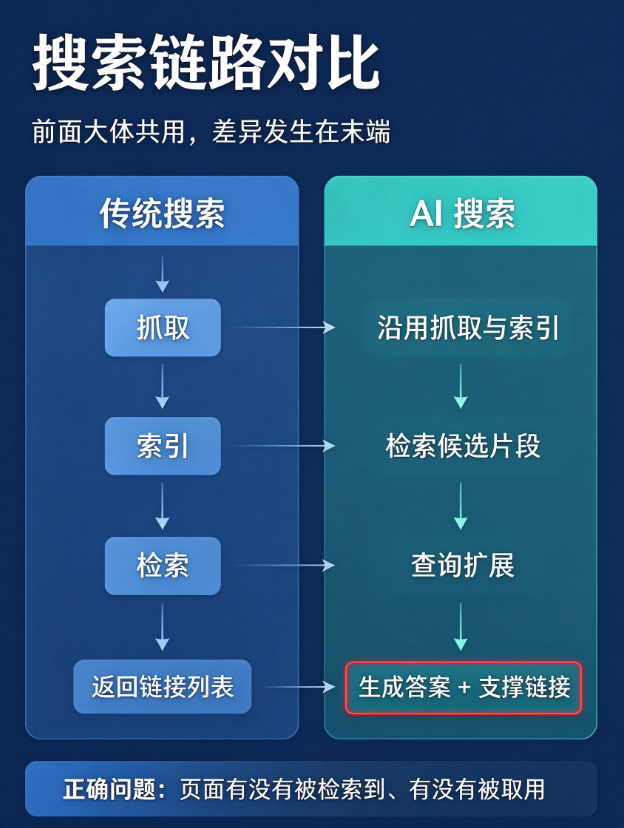
AI 搜索和传统搜索最大的差别不在「抓取」,而在「生成」。抓取和索引这两步,主流 AI 搜索复用的是已经存在的搜索索引——Google 官方文档写得很清楚:AI 概览(AI Overviews)和 AI 模式的内容来自 Google 的搜索索引,没有单独一套「AI 索引」。真正新增的是第三步:在检索到的页面之上,由模型再写出一段答案。对出海品牌来说,这意味着「被索引」只是入场券,「被检索到并且被引用」才是目的。
AI 搜索和传统搜索,差在哪一步?
传统搜索输出的是链接列表,AI 搜索输出的是答案加少量支撑链接。这个差别发生在链路的最末端,前面几步大体共用。把四步并排看,差异点就很清楚:
| 阶段 | 传统搜索 | AI 搜索 |
|---|---|---|
| 抓取 | 爬虫发现 URL、抓取页面,并渲染 JavaScript | 沿用同一套抓取与索引,没有独立的 AI 索引 |
| 索引 | 判断重复内容、选出正主、存入索引 | 同一份索引,但页面还必须允许以摘要形式展示 |
| 检索 | 按查询匹配已索引的页面 | 模型把一个问题拆成多个并发子查询,再分别检索 |
| 输出 | 返回按相关性排序的链接列表 | 基于检索到的页面生成答案,并挂出支撑链接 |
所以「AI 搜索会不会收录我」这个问题问错了方向。正确的问题是:我的页面在第三步有没有被检索到、第四步有没有被取用。而这两步的前提,仍然是前两步做得对。
第一步,抓取:谁在抓你的页面,抓到了什么
Googlebot 会渲染 JavaScript——按 Google 官方说明,它使用近期版本的 Chrome 执行页面上的 JS,和你自己用浏览器打开时类似。所以对 Google 来说,客户端渲染的内容通常还是能被看到的。
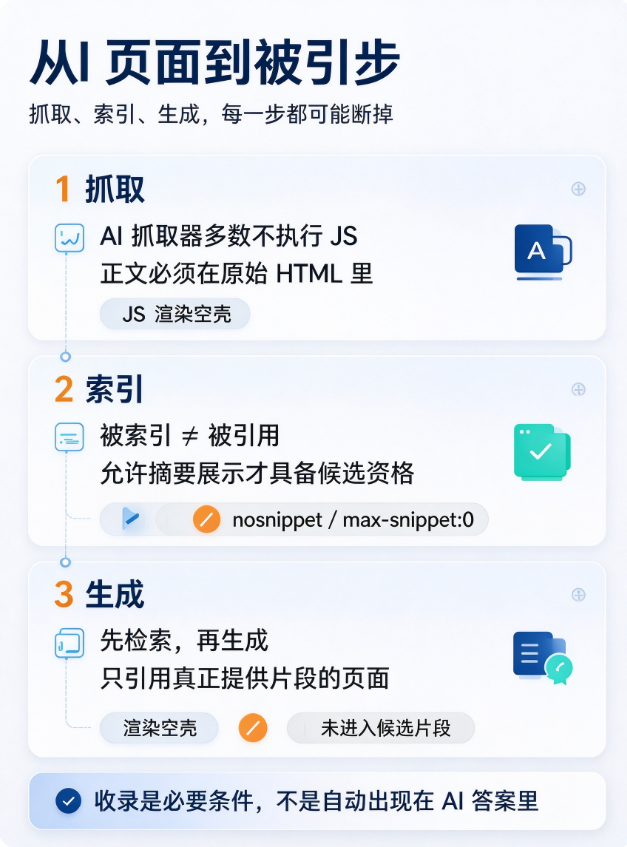
但 AI 侧的抓取器不是这样。GPTBot、PerplexityBot、ClaudeBot 这类抓取器绝大多数只读取服务器直接返回的 HTML,不执行 JavaScript。也就是说:如果你的正文是靠浏览器运行时才拼出来的,那它对一部分 AI 引擎等于不存在。
这是出海品牌最常见、也最容易自查的一个问题。检查方法很简单:在浏览器里禁用 JavaScript,刷新页面,看正文还在不在。如果只剩一个空壳,AI 抓取器看到的就是同一个空壳。云边科技把官网做成预渲染静态站,正文在构建期就写进 HTML,直接原因就是这一条。
第二步,索引:能被索引,和能被引用,是两件事
Google 官方对 AI 功能的技术要求写得很直接:页面必须已被索引,并且有资格以摘要形式(with a snippet)展示在 Google 搜索中。这一条经常被忽略——一个页面可以被索引,但因为设置了 nosnippet 或 max-snippet:0,不能以摘要形式出现,那它就不具备进入 AI 功能的前提。
还要接受一个事实:Google 明确说明不能保证抓取、索引或展示任何页面,即使页面完全符合规范。所以「我提交了 sitemap 就一定会被收录」是一个错误预期。能做的只是把该做的做对,然后观察。
常见的三类阻断,出海站点尤其容易踩:
- 抓取层阻断:robots.txt 误封、服务器对海外爬虫返回 5xx、CDN 按地区拦截
- 索引层阻断:页面上有 noindex、内容被判为重复、正文藏在需要登录或需要交互的位置
- 展示层阻断:nosnippet、max-snippet:0,页面能索引但不能以摘要出现
第三步,生成:多出来的这一段是怎么来的
这是 AI 搜索真正的增量。Google 官方把它拆成两个机制:
一是检索增强生成(RAG,也叫 grounding)。 系统先用搜索排名系统从索引里取出当下相关、更新的页面,再基于这些页面里的具体信息生成回答,并把支撑该回答的页面作为可点击链接挂出来。注意顺序:先检索,再生成。答案里的每一句话,都能追溯到某个被检索到的页面。
二是查询扩展(query fan-out)。 模型会把用户的一个问题拆成若干并发的相关子查询,分别去取更多资料再合并。Google 官方举的例子是:用户问「草坪长满杂草怎么修」,扩展出来的子查询可能是「草坪最好的除草剂」「不用化学药剂怎么除草」「怎么预防草坪长杂草」。
查询扩展对品牌的含义很具体:你被检索到的机会,不只取决于用户原话,还取决于模型为这个问题想出的那些子查询。 一个只回答主问题的页面,覆盖不到子查询;一份能顺带回答「怎么选」「多少钱」「多久」「有什么坑」的页面,覆盖概率更高。
为什么「被检索到」仍然依赖排名系统
Google 官方的表述是:生成式 AI 功能「建立在核心搜索排名与质量系统之上」。这句话否掉了一类流行的说法——好像存在一套独立的、需要特殊技巧才能通过的 AI 通道。
实际上,排名与质量系统决定了哪些页面有资格进入检索池。所以 SEO 的基本功不是被 GEO 取代,而是变成了 GEO 的输入项:技术可访问性、内容质量、页面体验、语言与国家信号,都还在起作用。区别只在于,最终评判从「排在第几位」变成了「这段话能不能被取走」。
一个常见误解:需要为 AI 单独做一套东西吗?
Google 官方专门列了一份「可以忽略」的清单:不必创建 llms.txt 之类的特殊文件或标记、不必把内容切成一小块一小块、不必为 AI 重写一遍内容、不必去追求不真实的「提及」、也不必过度依赖结构化数据。这不是说这些东西完全没价值,而是说它们不是 AI 可见度的必要条件。
这个判断和第三方实测是吻合的。Ahrefs 追踪了 1,885 个在 2025 年 8 月至 2026 年 3 月之间新增 JSON-LD 结构化数据的页面,结论是:加上结构化数据之后,各平台的引用率都没有出现有意义的提升。 结构化数据依然值得用——它帮助获得富媒体搜索结果——但它不是让 AI 引用你的杠杆。
出海品牌可以立刻做的三件事
- 确认正文静态可读。 禁用 JavaScript 看一遍,全文都在才算过关。这是很多中国品牌站最容易失手的一步。
- 确认页面可索引、且允许摘要。 检查 robots、noindex、nosnippet,并确认海外访问不会被服务器或 CDN 拦掉。
- 把结论写在段落最前面。 既然答案是逐段取走的,那每一段最好都能独立成立——先给结论,再给理由。这一点在把 SEO 套路搬过来做 GEO:6 个失效点里有更细的对照。
安徽云边出海科技开发有限公司在做站点诊断时,把这三项放在最前面查,因为它们属于「不做就一定没结果、做了也不保证有结果」的类型。再往外一层才是信源与内容布局,那部分需要按月推进,见方法与交付。
常见问题
AI 搜索有自己单独的一套索引吗?
主流 AI 搜索没有。Google 官方的说法是,AI 概览与 AI 模式的内容来自 Google 的搜索索引,不另建一套。所以任何声称「有专门的 AI 收录渠道」的说法,都值得先问依据。
页面被 Google 收录了,就会出现在 AI 答案里吗?
不会自动发生。收录只是必要条件之一,页面还需要允许以摘要形式展示,并且在这个问题被检索时进入候选池。收录和「被引用」之间还有一段概率。
为什么我的站 Google 能看,ChatGPT 却看不到?
最可能的原因是 JavaScript。Googlebot 会渲染 JS,多数 AI 抓取器不会,只读服务器返回的原始 HTML。另外也要检查 robots.txt 里是否单独屏蔽了 GPTBot 这类抓取器。
「查询扩展」对我的内容策略有什么影响?
影响很直接:一个用户问题会变成一个子查询集合。所以与其为每一个词写一篇,不如把一个问题周边的决策细节——怎么选、多少钱、多久、常见坑——在同一篇里讲清楚。
要不要专门做一套给 AI 看的页面?
不需要。Google 官方明确说不需要为生成式 AI 做特殊标记或专门文件,也提到了不需要为 AI 切块或重写内容。把同一份内容做得结构清晰、结论前置,对人和对 AI 都有用。
多久能看到 AI 层面的变化?
没有可靠的通用周期。抓取和索引的更新速度取决于站点权重与更新频率,而 AI 答案本身是概率性的——同一个问题问两次都可能有措辞差异。所以判断趋势要靠固定问题集连续多期记录,单次结果不足以说明问题。